Teknologi pembuatan subtitle

Cara Weydub Membuat Subtitle dengan Kode Waktu dari Video menggunakan OCR dan ASR

Subtitle produksi bukan sekadar transkrip yang diberi stempel waktu belakangan. Weydub menggunakan dua alur kerja terpisah: OCR video temporal untuk teks yang sudah menyatu dengan gambar dan ASR siap subtitle untuk dialog yang hanya ada dalam audio.

98.25%Akurasi karakter OCR
98.92%recall cue ketat
300K+episode drama pendek yang diproses setiap hari
Analisis sumber langsung OCR VIDEO / SRT
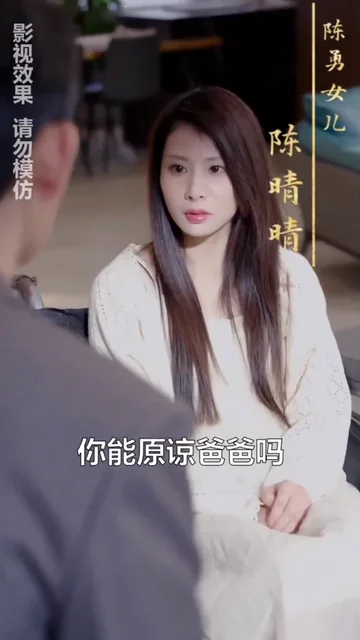
DIALOG / PERTAHANKAN PENAFIAN / KECUALIKAN KARTU KARAKTER / KECUALIKAN
OUTPUT YANG DAPAT DIEDITSRT
CUE

Bisakah kamu memaafkan Ayah?

Cue dialogdipertahankan
Elemen teks adegandikecualikan

Satu frame sumber dapat memuat beberapa kelas teks yang terbaca. Hanya dialog yang termasuk dalam lini masa subtitle.

Demo drama pendek publik yang nyata digunakan untuk menjelaskan klasifikasi subtitle. Hak atas konten yang mendasarinya tetap dimiliki oleh pemilik konten.

Benchmark drama pendek dengan judul yang sama

Akurasi paling penting di bagian yang langsung dirasakan operator: lini masa cue

Weydub mengevaluasi jalur OCR subtitle hardcode miliknya terhadap satu baseline ASR khusus audio yang diuji pada set validasi drama pendek dengan judul yang sama, menggunakan referensi subtitle editorial yang ditinjau manusia sebagai acuan utama.

Yang diukurPerbandingan alur kerja berbasis referensi subtitle, bukan rata-rata sumber terbuka atau benchmark WER ASR universal. Baseline audio menggunakan ElevenLabs Scribe v2 pada vokal yang telah dipisahkan.

Penjelasan teknis

Cara Kerja Pembuatan Subtitle AI: OCR Video vs ASR

Ikuti dua jalur sinyal terpisah dari video sumber hingga SRT dengan kode waktu yang dapat diedit, lalu lihat mengapa akurasi pada tingkat cue lebih penting daripada satu skor pengenalan.

Pilih sumber yang lebih kuat

Satu video dapat memiliki dua sumber acuan yang berbeda

Gunakan OCR jika video sudah berisi subtitle hardcode yang andal. Gunakan ASR jika dialog ada dalam audio, tetapi tidak ada teks subtitle layak pakai yang terlihat.

Drama pendek memperjelas perbedaannya. Musik, efek, aksen, tangisan, teriakan, bisikan, suara yang saling tumpang tindih, dan dialog sehari-hari dapat mengganggu pengenalan ucapan. Trek subtitle yang diedit secara profesional sering kali merepresentasikan dialog yang dimaksud dengan lebih bersih.

OCR / 01

Baca sinyal editorial dalam gambar

Paling cocok untuk subtitle yang menyatu dengan gambar, takarir, dan teks dialog yang terlihat. Tantangan utamanya adalah mengubah deteksi berulang dari tiap frame menjadi satu lini masa yang stabil sekaligus menyaring teks adegan.

  • Pemrosesan area dan waktu secara otomatis
  • Agregasi temporal lintas frame
  • Pemfilteran teks adegan dan koreksi konservatif
ASR / 02

Ubah ucapan menjadi subtitle, bukan paragraf

Paling cocok saat trek audio menjadi satu-satunya sumber dialog. Pengenalan hanyalah langkah pertama; segmentasi subtitle agar mudah dibaca, pengaturan waktu, panjang baris, dan pergantian pembicara menentukan apakah hasilnya dapat digunakan.

  • Pengenalan ucapan dengan pengaturan waktu per kata
  • Segmentasi semantik dan akustik
  • Deteksi pembicara opsional jika didukung

OCR Video

OCR gambar melihat frame. Sistem subtitle memahami waktu.

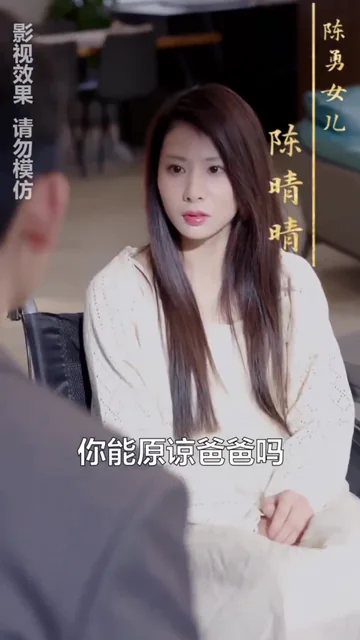
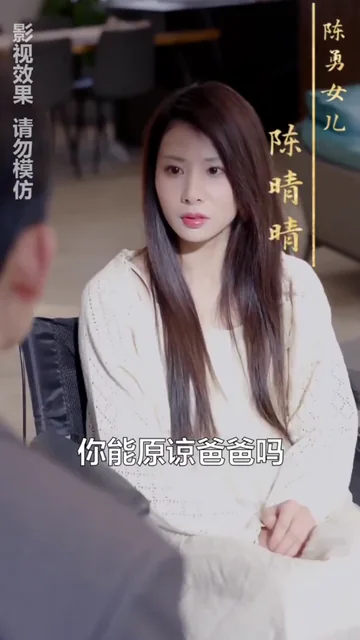
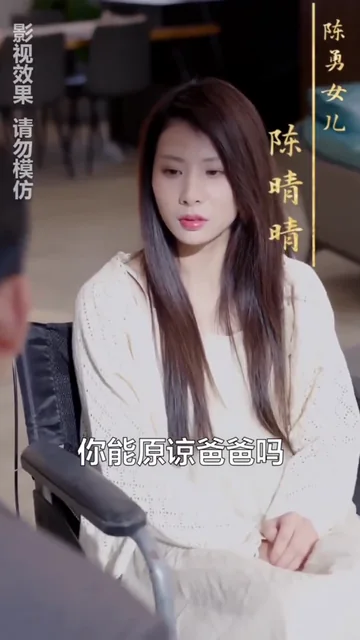
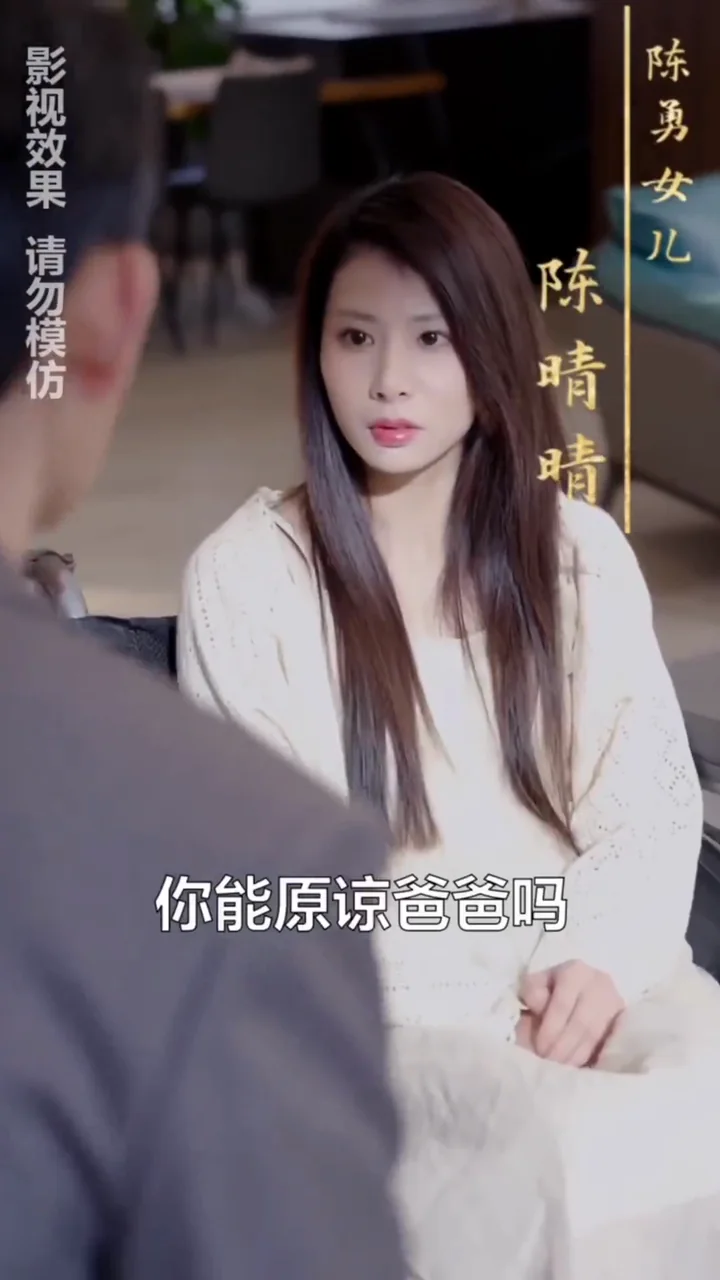
Pada 30 fps, satu menit video berisi 1.800 frame. Menjalankan OCR generik secara terpisah pada setiap frame mengulang pekerjaan dan menghasilkan kotak teks duplikat. Produk subtitle video harus menghubungkan hasil pengamatan tersebut menjadi peristiwa subtitle dengan kode waktu.

SATU SUBTITLE DI SEPANJANG FRAME YANG DISAMPEL00.50s → 00.95s
Frame 15 drama pendek pada 0,50 detik yang menampilkan subtitle dialog yang samaFRAME 01500.50s
Frame 20 drama pendek pada 0,65 detik yang menampilkan subtitle dialog yang samaFRAME 02000.65s
Frame 24 drama pendek pada 0,80 detik yang menampilkan subtitle dialog yang samaFRAME 02400.80s
Frame 29 drama pendek pada 0,95 detik yang menampilkan subtitle dialog yang samaFRAME 02900.95s
KEPUTUSAN PENGGABUNGANSatu cue, bukan empat deteksi duplikat
00:00:00,420 --> 00:00:02,260
你能原谅爸爸吗
Deteksi berulang dapat dikelompokkan sepanjang waktu menjadi satu peristiwa subtitle yang stabil. Visual ini menjelaskan masalah sistem dan tidak mengungkapkan implementasi milik Weydub secara mendetail.
01

Deteksi kandidat

Gunakan area yang relevan atau seluruh frame untuk menemukan teks yang mungkin termasuk dalam trek dialog.

02

Agregasikan lintas waktu

Kelompokkan deteksi yang berdekatan berdasarkan teks, posisi, dan durasi kemunculannya untuk memperkirakan satu peristiwa yang stabil.

03

Filter dan koreksi

Kurangi teks adegan yang tidak terkait dan perbaiki gangguan pengenalan yang jelas tanpa mengarang dialog.

04

Susun lini masa

Gabungkan fragmen, tetapkan batas awal/akhir, dan ekspor peristiwa subtitle SRT yang dapat diedit.

Pengendalian hasil positif palsu

Mengenali setiap kata tidak sama dengan membuat subtitle

Frame dapat memuat papan tanda, layar ponsel, label produk, logo, kartu nama, peringatan, dan overlay promosi. Weydub menyediakan pemfilteran teks adegan karena trek subtitle seharusnya berisi dialog, bukan setiap piksel yang dapat dibaca.

AreaFokuskan ekstraksi pada area subtitle.
WaktuBatasi pemrosesan pada interval yang relevan.
BahasaTerapkan sistem tulisan dan jalur pengenalan yang tepat.
PeninjauanTetap tampilkan hasil yang meragukan kepada operator.
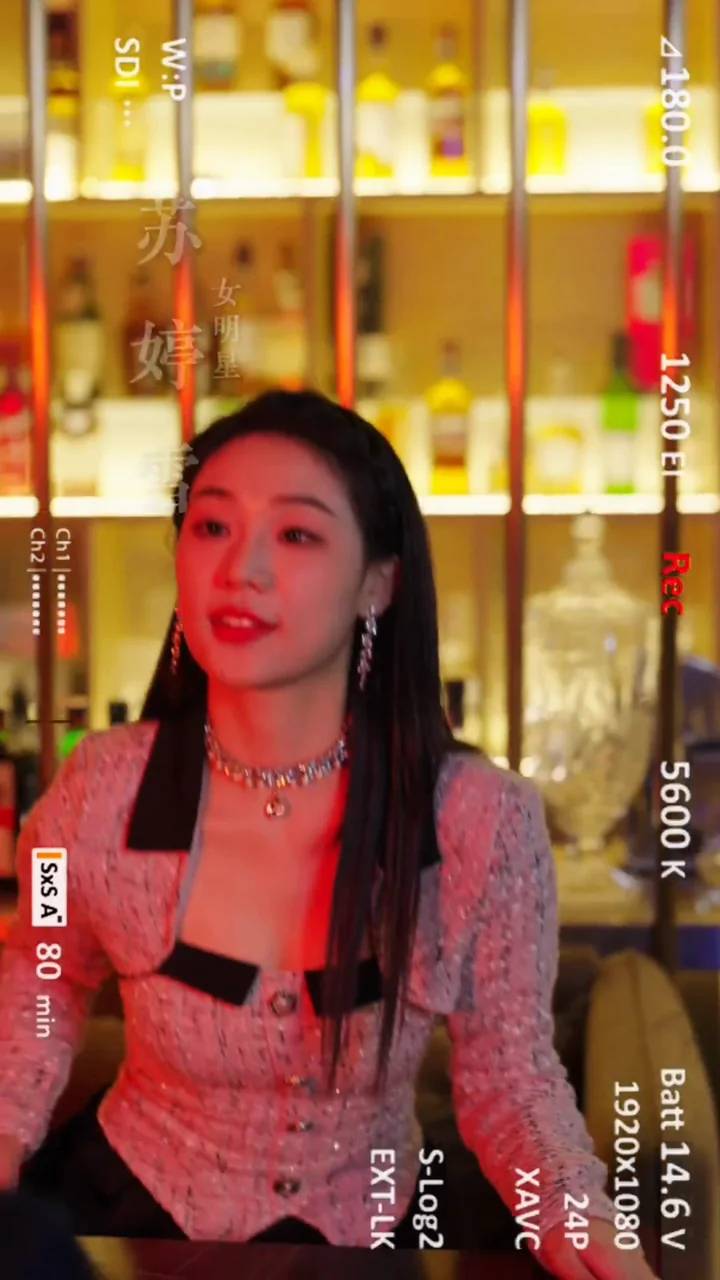
Frame drama pendek yang memuat subtitle dialog, penafian, dan kartu karakter
PERTAHANKAN SEBAGAI SUBTITLESubtitle dialog

Ucapan ini perlu dimasukkan ke trek subtitle bertanda waktu.

KECUALIKAN: PENAFIANPenafian keselamatan

Teks hukum atau produksi yang terus tampil bukanlah dialog.

KECUALIKAN: KARTU KARAKTERGrafis nama dan peran

Overlay identitas karakter tidak dimasukkan ke linimasa dialog.

Frame drama pendek dengan antarmuka kamera yang padat dan teks dekoratif yang tidak boleh dijadikan cue subtitle
KECUALIKAN: UI KAMERATeks antarmuka teknis

Parameter, skala, dan overlay perangkat tetap menjadi bagian dari gambar.

Teks yang terbaca belum tentu dialog.

OCR video harus mengklasifikasikan teks sebelum dapat menghasilkan file subtitle yang berguna.

Frame nyata dari demo publik menggambarkan masalah klasifikasi ini. Hak atas konten yang ditampilkan tetap berada pada pemilik konten tersebut.

ASR siap subtitle

Transkrip yang benar masih bisa menjadi file subtitle yang buruk

ASR tradisional mengenali ucapan. Pembuatan subtitle menambahkan penentuan cue: membagi aliran kata menjadi cue ringkas, mudah dibaca, dan bertanda waktu yang sesuai dengan makna kalimat, jeda, pergantian pembicara, serta batasan tampilan.

Konteks sumber terbuka

Tidak ada rata-rata universal yang bermakna untuk membandingkan OCR dan ASR

Proyek publik mengukur sinyal yang berbeda pada set data yang berbeda. Proyek tersebut berguna untuk menunjukkan seberapa besar akurasi berubah berdasarkan sistem tulisan, bahasa, derau, dan kondisi perekaman. Namun, proyek tersebut bukan satu papan peringkat untuk kesiapan subtitle video.

PP-OCRv5Akurasi pengenalan 80.27% hingga 94.20%

Akurasi pengenalan pada set data multibahasa khusus sistem tulisan yang telah dipublikasikan. Ini mengukur pengenalan teks, bukan alur kerja subtitle video berbasis waktu dari awal hingga akhir.

Baca tolok ukur PaddleOCR
Whisper large-v2Rata-rata WER 12.8% pada 14 set data bahasa Inggris

Makalah yang sama melaporkan 2.7% pada LibriSpeech clean, 25.5% pada ucapan berderau CHiME-6, dan 36.4% pada ucapan jarak jauh AMI. Kondisi perekaman mengubah hasil secara drastis.

Baca makalah Whisper
Kesimpulan untuk produksi bukanlah bahwa satu modalitas selalu lebih unggul. Kesimpulannya: gunakan sinyal sumber paling bersih yang tersedia. Dalam drama pendek dengan subtitle hardcode yang akurat dan audio campuran yang berderau, trek visual sering kali menjadi sumber yang lebih baik.
Operasi, bukan metrik yang sekadar terlihat bagus

Selisih beberapa poin akurasi dapat berarti peninjauan selama berminggu-minggu

Pada seri yang berjalan lama, kepadatan kesalahan yang rendah memungkinkan peninjauan sampel secara terfokus. Kepadatan kesalahan yang tinggi memaksa operator meninjau baris demi baris, sehingga koreksi subtitle menjadi hambatan produksi.

Setiap koreksi mengharuskan seseorang menemukan cue, memutar ulang konteks, memverifikasi kata-kata yang dimaksud, mengeditnya, lalu memeriksanya kembali. Saat kesalahan sangat padat, operator tidak lagi memercayai hasil dan meninjau setiap baris.

KEPADATAN KESALAHAN RENDAHPeninjauan sampelantrean koreksi yang terkendali
KEPADATAN KESALAHAN TINGGIPeninjauan baris demi barishambatan produksi
Beban kerja koreksi pada skala seri

Kualitas lokalisasi

Kualitas subtitle sumber menentukan batas kualitas proses selanjutnya

Banyak kesalahan yang tampak seperti kesalahan penerjemahan atau dubbing sebenarnya bermula lebih awal. Kata sumber yang salah, batas cue yang buruk, atau pergantian pembicara yang keliru diteruskan ke setiap model berikutnya. Lihat bagaimana linimasa sumber yang andal menjadi masukan bagi penerjemahan subtitle berbasis konteks pada tingkat seri lalu mendukung dubbing AI berbasis karakter dan penyelarasan audiovisual.

Penyerahan hasil produksi

Dari satu video ke alur kerja Studio dan API yang dapat diulang

Kualitas pengenalan penting, tetapi produksi juga memerlukan batch, pelacakan status, hasil yang dapat diedit, callback, serta serah terima yang lancar ke penerjemahan dan dubbing AI.

STUDIO

Atur proyek dan batch

Unggah beberapa episode, pilih OCR atau ASR untuk setiap sumber, dan kelola pekerjaan seri yang berulang dalam satu ruang kerja produksi.

Pelajari alur kerja Studio
PEKERJAAN

Lacak status dan kumpulkan hasil

Tinjau status tugas, buka hasil tugas yang telah selesai, unduh SRT yang dapat diedit, lalu lanjutkan ke penerjemahan atau dubbing.

Baca panduan pembuatan subtitle
API

Otomatiskan tugas asinkron

Kirim tugas OCR atau ASR, simpan ID proyek dan pekerjaan, lalu gunakan polling atau pengiriman melalui callback dalam pipeline media Anda sendiri.

Baca referensi API

Jawaban yang jelas

FAQ pembuatan subtitle AI

Definisi yang ditulis untuk operator, pengembang, mesin pencari, dan sistem AI yang memerlukan deskripsi akurat tentang alur kerja ini.

Apa itu pembuatan subtitle AI?

Pembuatan subtitle AI mengubah teks yang terlihat atau dialog lisan menjadi cue subtitle bertanda waktu. Hasil produksi mencakup teks, waktu mulai/selesai, segmentasi cue yang mudah dibaca, informasi bahasa, dan format yang dapat diedit seperti SRT.

Bisakah OCR mengekstrak subtitle hardcode dari video?

Ya. OCR video dapat mendeteksi teks yang menyatu dalam frame, mengelompokkan deteksi berulang sepanjang waktu, memperkirakan batas cue, memfilter teks adegan yang tidak terkait, dan mengekspor cue subtitle bertanda waktu.

Mengapa menggunakan OCR alih-alih ASR untuk drama pendek?

Jika subtitle yang tertanam akurat, OCR membaca sinyal teks editorial yang tidak terlalu terpengaruh oleh musik, efek, aksen, tangisan, teriakan, bisikan, dan dialog yang tumpang tindih.

Mengapa transkrip yang benar masih bisa menjadi subtitle yang buruk?

Transkrip dapat berupa satu paragraf panjang atau memiliki batas yang tidak sesuai dengan kecepatan membaca. ASR siap subtitle harus membuat cue ringkas bertanda waktu dengan batas semantik dan pergantian pembicara yang masuk akal.

Apakah Weydub menggabungkan OCR dan ASR secara otomatis?

Tidak. OCR dan ASR adalah mode pembuatan yang terpisah. Tim dapat membandingkan hasilnya saat peninjauan, tetapi Weydub tidak menyebut setiap tugas sebagai alur kerja OCR/ASR yang digabungkan secara otomatis.

Bangun linimasa sumber yang lebih baik

Buat file subtitle yang dapat diandalkan oleh alur kerja lokalisasi Anda.

Pilih OCR untuk teks yang tertanam atau ASR untuk ucapan, tinjau SRT bertanda waktu, lalu lanjutkan ke penerjemahan, dubbing AI, dan ekspor.

Mulai dengan Weydub